“为用户设计、定制、搭建和运维HPC集群系统,统一管理仿真数据,灵活配置池化资源,融合GPU远程三维可视化组件,实现HPC集群高效稳定运行、按需调度、有效管理,帮助制造企业高效率、低成本地实现工程仿真设计需求。”
——付鸿雁 联科集团联席合伙人
前言
产业巨大变革中,工业与互联网加速融合,“中国制造”迈向“中国智造”,升级到高端制造,需要能产生高附加值、高技术含量的创新型产品。
中国制造迈向工业4.0,高性能计算从科学研究领域扩展至企业、商业应用,对于制造业创新起到强力的催化作用,可以帮助制造型企业完成精准、可靠的仿真模拟分析过程,促进企业甚至整个工业制造业的创新。
4月15日,联科集团将联合戴尔科技集团、英特尔公司多位专家在线探讨、解读高性能计算在智能制造领域的新趋势、新价值。
现梳理本次直播的演讲实录供大家参考学习,以下为分享原文:
各位嘉宾下午好,我是联科集团付鸿雁。欢迎各位嘉宾来参加联科集团和戴尔联合举办的本次客户活动。
我分享的主题是《联科企业级高性能计算解决方案 破译制造业HPC新价值》。
智能制造行业中 高性能计算的价值
在制造行业中,仿真设计流程通常分为三个部分:
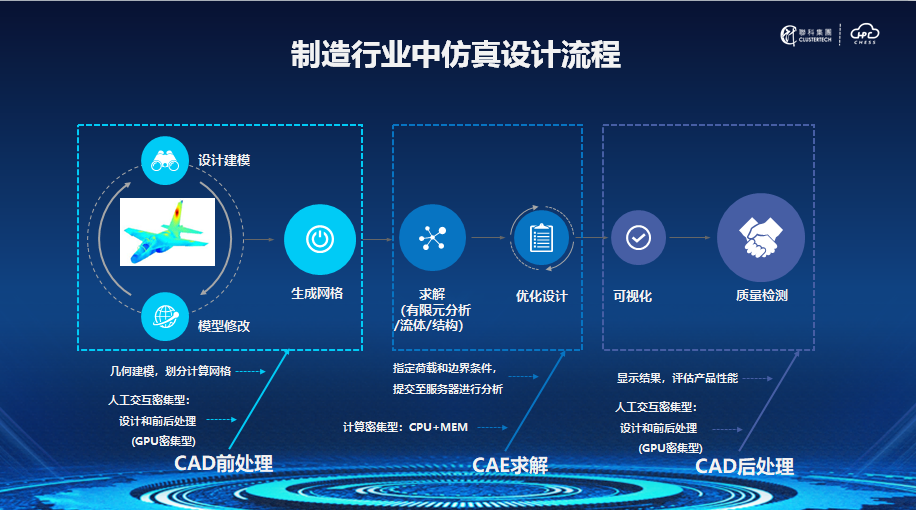
CAD前处理,主要是使用GPU做三维建模;
CAE求解计算,会用到大量CPU和内存来计算,这部分就需要由高性能计算平台来支撑;
CAD后处理,用来检验计算结果是不是满足要求。
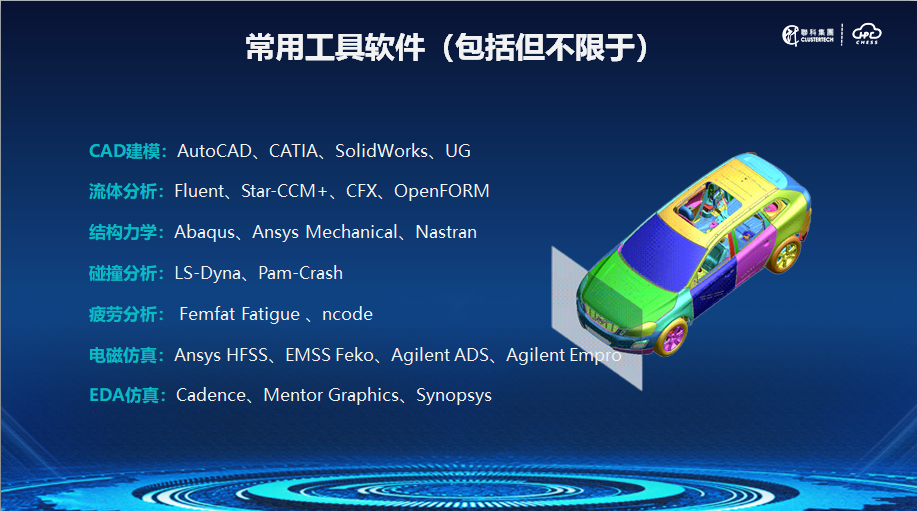
常见的应用软件有建模的、流体分析的、结构力学的、碰撞分析的等。
高性能计算有什么价值?
高性能计算可以减少计算时间、降低成本,也可以增加计算规模,提升效率。
一增一降就可以提升企业效率,加速科研进程。
因此现在很多企业都通过建设HPC集群来促进生产和研发。
但在集群建设和使用过程中也会遇到很多问题。
所有问题总结起来其实就是两大类:一个是怎么买好集群,一个是怎么用好集群。
从IT工程师角度来看,如何结合业务场景中不同CAE软件来做方案规划设计,如何搭建可靠应用的集群系统?如何确保软件、硬件性能达到最优?如何有效管理和使用HPC集群,以及如何保障集群的性能持续最优?
从CAE工程师角度来看,集群使用经验不足,如何快速进行仿真设计?如何更好地与应用软件结合,方便作业提交?不熟悉Linux操作系统的时候,怎样快速处理数据和使用集群?
这些问题都是摆在用户面前的困难。
CAE仿真中使用HPC的价值有这样几个方面:
HPC可以解决更多、更复杂的问题。
例如,一些模型细节的精确需要的模拟网格数更大,精度就可以更高,也可以从单一零件的模拟到整机的模拟。
HPC可以加速研发的进程。
HPC集群的处理能力强、计算速度快,可以迅速完成大量任务的计算,提高了设计质量和效率。
HPC可以降低投入成本。
通过计算可以减少实验的次数和成本。比如制造一个飞机或者设计汽车外形,不可能做出很多模型去实验,周期很长,成本也太高。
HPC可以提升研发设计人员的效率。
实验次数降低,实验时间缩短,自然研发设计的效率就会提升,成本也就下降了。
HPC促使投资收益最大化
资源集中管理,提高利用率,不是零散、分散的使用模式。软件集中安装部署,也降低了运维成本。
最后一个方面是HPC可以提升企业的竞争力
使用HPC集群进行仿真设计可以缩短企业产品上市周期,加快企业推出新产品,更快占领市场。
联科制造行业HPC解决方案
联科面向工程仿真设计解决方案基于联科集团自主研发的CHESS 高性能计算管理平台和二十多年的行业经验的积累,为用户设计、定制、搭建和运维HPC集群系统,统一管理仿真数据,灵活配置池化资源,融合GPU远程三维可视化组件,实现HPC集群高效稳定运行、按需调度、有效管理,帮助制造企业高效率、低成本地实现工程仿真设计需求。
联科制造行业HPC解决方案的思路是应用为核心,以硬件和软件为基础。
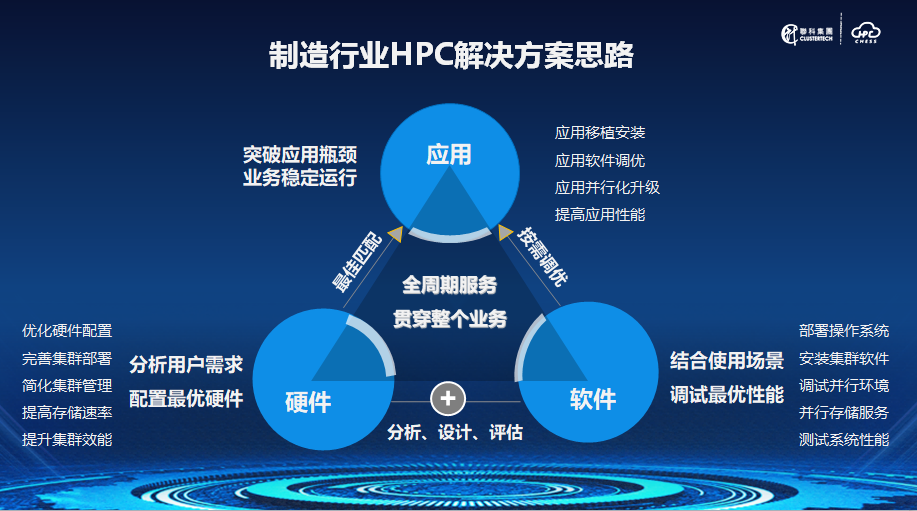
硬件方面,分析用户需求、设计和搭建适合用户场景的最优方案,使应用和硬件达到最佳匹配的效果。
软件方面,结合使用场景,围绕应用按需调优,达到整套集群系统和应用软件的最佳性能,同时也提供符合使用习惯的操作流程。
应用方面,在所提供可靠、稳定和性能最优的软硬件平台基础之上,获得应用软件的最佳性能。
在整个HPC架构里面,最重要的也就是应用软件的性能,所有的软件和硬件都要为应用服务,都要以提升应用效率为目的。
联科的制造行业HPC解决方案有以下几个优势:
第一个,联科集团专注高性能计算二十多年,也交付了上千个项目,所以我们可以做到真正以应用为核心,深度贴合用户的业务逻辑。
第二个,提供从系统层到应用层的解决方案,帮助用户解决买好和用好集群的问题。
第三个,优化传统集群建设的思路,按需调优软硬件的配置,保证应用性能的最优。
第四个,提供一个国产化的集群管理平台,保障信息安全。
第五个,高效融合了很多生态合作伙伴,提供多业务、跨平台的技术整合,最终实现用户复杂需求的精准匹配。
第六个,提供贯穿全业务周期的服务,也积累了一个HPC专家团队,可以为用户集群的建设和运维保驾护航。
联科制造行业HPC解决方案由四个部分构成,包含设计、建设和运维的全过程,以及通过服务实现最优的应用性能。
方案设计:
在方案设计中要遵循高可靠、易用性、通用性、数据安全、可视化原则。根据用户需求进行分析,在此基础上进行方案设计以及成本评估。如用户有需求,可以提供POC验证测试,最终与用户确认方案。
这里我们画了一个典型的HPC结构图,从这张图展开说明方案设计。
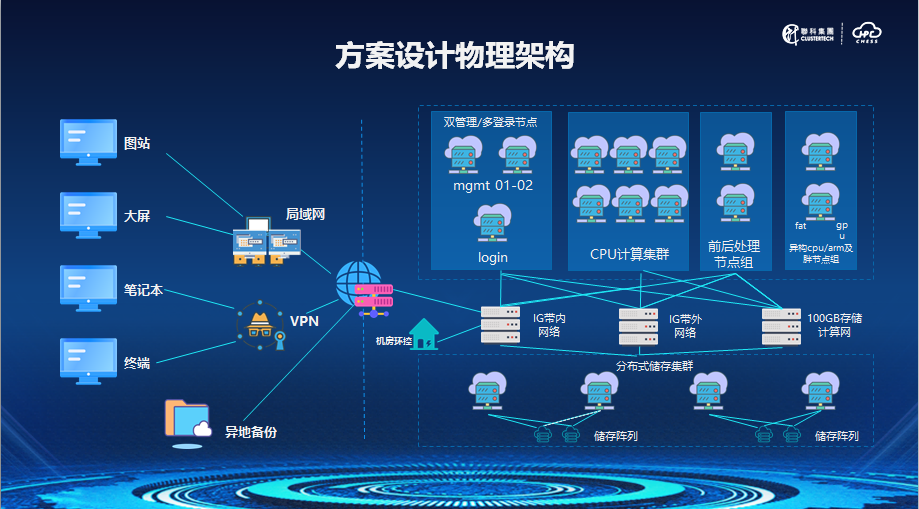
右上角这些都是节点,节点也是HPC的核心部件,它决定着HPC集群的整体性能,因此节点CPU的选型和内存的配置也尤为重要。
我们根据用户的实际场景来选择,是使用Intel的或者是AMD的CPU,还是GPU卡。
如果我们选择了Intel的处理器,也要看具体是哪种型号的。
接下来是网络,这是连接集群中各个部件的,也要根据不同的使用场景来匹配,是选择万兆IB还是OPA。
下面的存储具体选什么样的架构以及并行文件系统来搭建,也要看应用对存储性能的需求。
另外集群的软件有Open Source的、也有商业版本的,操作系统有Windows的,也有Linux的。
还有在制造行业中,我们经常会遇到远程三维可视化的场景,这些都是方案设计中要考虑的因素。
集群建设:
我们在HPC领域里面积累了很多年,也有多名实施经验非常丰富的工程师,积累了大量知识库、问题库、软件库,为集群建设、平台上线稳定运行、保驾护航。
集群建设是整个集群搭建的重头戏,整个过程包括硬件的部署、操作系统的部署、集群软件的安装。集群系统搭建好后,需要进行整机的性能优化,并在保证集群性能正常的情况下,进行应用的安装、调试和优化,最后给用户提供文档和培训。
具体来说,集群系统的建设包含硬件和软件两个方面:
硬件搭建包含所有硬件的上架、布线和加电测试。
软件搭建有以下几个步骤:
首先是系统软件的安装,包含操作系统、管理软件、文件系统、驱动和数据库。
在此之上是作业调度软件的安装,比如我们的自研产品CHESS,还有IBM LSF、开源的Slurm、PBS。
然后是应用软件的安装,最后将应用软件与整套平台做集成和对接。
这里特别强调一下,并行文件系统的IO很可能在集群中是一个瓶颈,所以我们在建设过程中也要保障IO的性能。因此我们提供BeeGFS、Lustre和GPFS这三种常用并行文件系统的安装和服务。
在HPC建设过程中,也需要对整套系统和应用的性能进行测试、评估和优化。
首先就是硬件的性能测试,对整套集群进行单机/整机Linpack、内存带宽、IO和网络性能的测试,来诊断硬件是不是存在故障。
在保障硬件性能达到最优的情况下,安装、调试应用软件,并给用户提供应用的分析和测试以及优化报告。
交付中,也会给用户提供培训,包含管理员和用户的使用培训。
提供交付文档,包含管理员手册、用户手册、测试报告和实施报告。
集群运维:
HPC集群庞大而复杂,是一个有机整体,集群可靠性发挥有赖于每个设备的正常运行、协调一致,任何一个环节出现故障,都有可能造成巨大损失。因此,对整个HPC系统的管理越来越重要,而难度越来越大。
联科HPC集群运营方案基于CHESS高性能计算集群管理平台,以先进、实用、稳定、可靠、全面的原则,建立一套完善的HPC管理和运维系统,实时监控整个集群软硬件运行状况,迅速定位、处理故障。
简化IT中心集群维护工作,提升业务部门软件应用效能。
提供报表等功能可以助力管理人员进行扩容或者升级等决策,实现HPC全方位的运维服务。
售后服务方面,帮助用户去排查硬件、操作系统、文件系统、作业调度系统、监控软件、应用软件的故障。
同时也提供系统巡检服务,保障集群系统持续、稳定、高效运行。
系统及应用的优化:
建设和搭建HPC集群最重要、最关注的是什么?
毫无疑问是性能。
而影响性能的主要因素有CPU、内存、网络、IO、编译参数或者运行参数等等。
因此在实施过程中,非常关键的一步,是要协助用户针对其应用进行性能的瓶颈分析和优化。
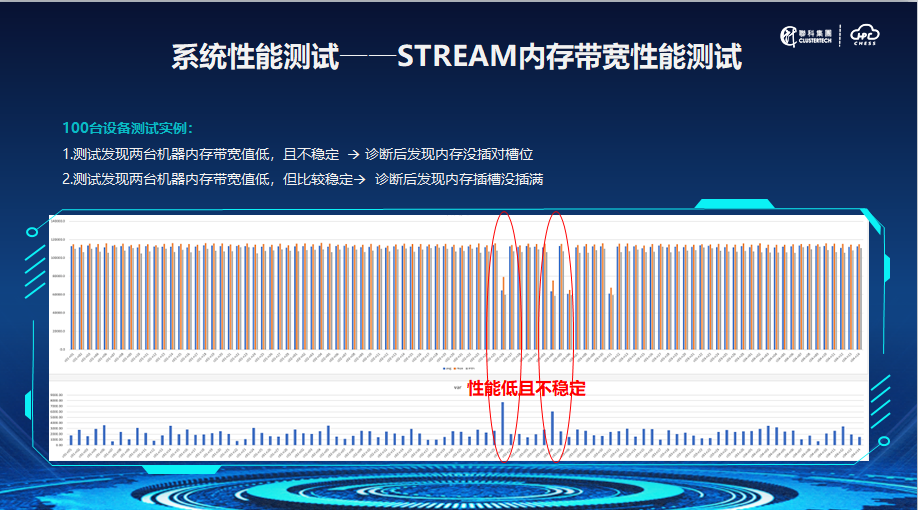
这是内存带宽测试的一个实例,我们对一百台机器进行了内存带宽的测试,发现有四台机器内存带宽有点偏低,其中有两台是持续稳定的低,每次测试它都低,另外有两台它不稳定,时高时低。
诊断之后我们发现稳定持续的低其实是内存槽没有插满,而低且不稳定的其实是内存条没有插对。经过一些调整之后,整套集群的内存带宽都达到了比较均衡的这个水平。
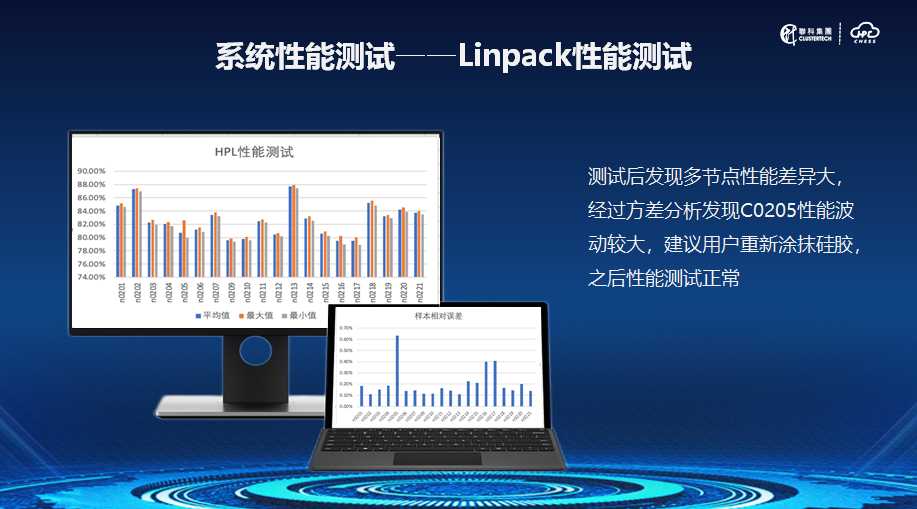
这是CPU性能测试的一个实例。用户的集群用了一段时间之后,我们在巡检的时候做性能测试,发现其中C0205这台机器我们经过多次测试之后,它方差比较大,经过各种分析诊断。
建议用户把硅胶涂一涂,涂了之后整套机群的性能就正常了。
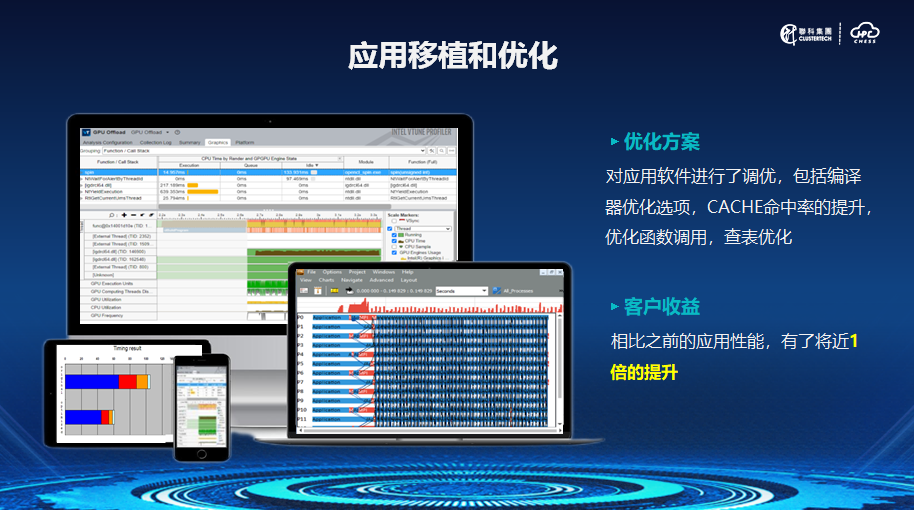
这是应用移植和优化的一个案例,这是气象的一个应用,我们对应用软件进行了调优,包含编译器优化、CACHE命中率的提升、函数的优化以及查表的优化,最后用户的应用性能提升了一倍。
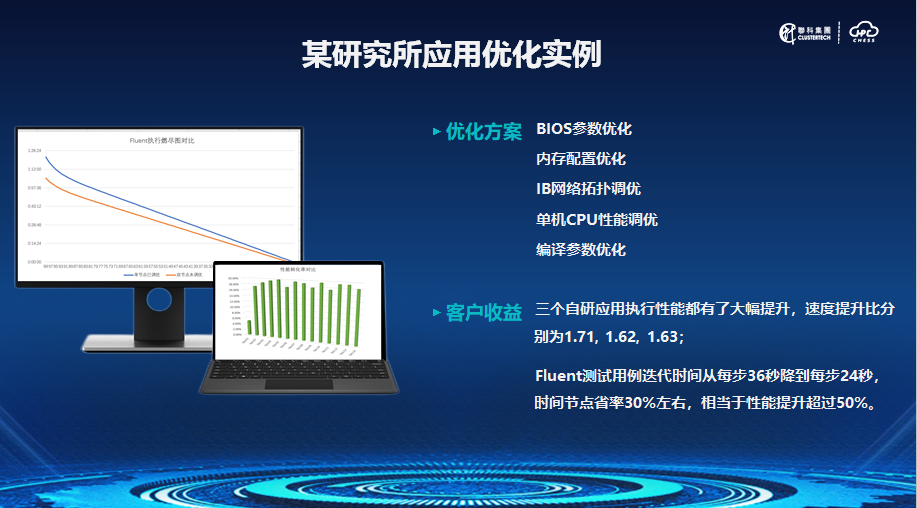
这是给某个研究所做的一个应用优化的实例。
我们优化的主要几个点,包含Bios参数的优化、内存配置的优化、IB网络拓扑调整、单机性能的优化以及编译参数的优化。
最后用户的三个自研应用性能都有了大幅提升,提升速度分别为1.71、1.62和1.63倍。
Fluent的测试每一步的计算时间,从36秒降到24秒,也就是说相当于性能提升了百分之五十。
方案核心产品
我们提供的核心产品是CHESS高性能计算管理平台,这是联科自主研发的一套集群管理软件。
CHESS高性能计算管理平台( ClusterTech HPC Environment Software Stack )是联科自主研发的高性能集群软件,采用B/S架构,通过浏览器进行操作实现集群资源统一部署、管理、调度、监控、报警、报表和计费,可将本地松散堆叠的服务器变成一整套HPC集群系统,同时在本地资源不足时可调用公有云资源,大幅提高集群效率,简化集群管理和运维。CHESS从2001年发布第一个版本以来,到现在已经走过二十多个年头,于上个月发布了6.6版本。
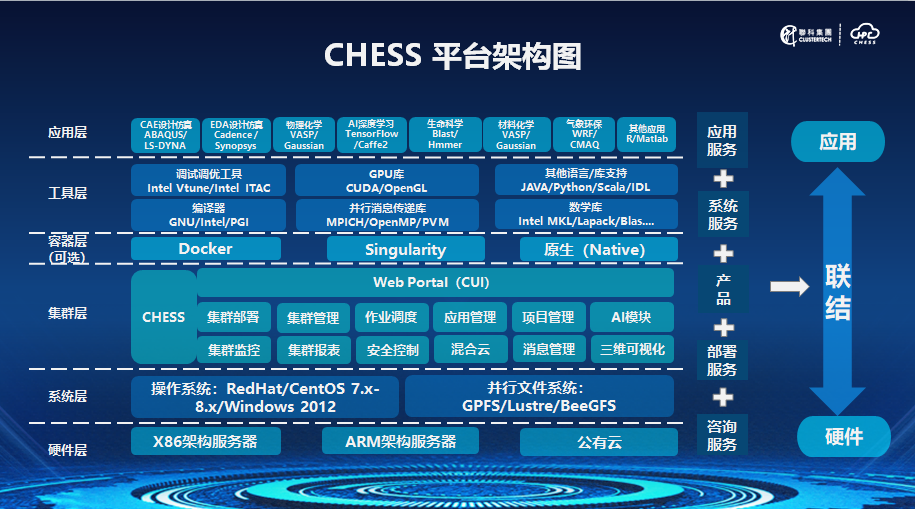
这是CHESS的架构图。
最底层硬件层,CHESS支持X86服务器、ARM服务器和公有云资源。
再上一层是系统层,CHESS支持操作系统RedHat和CentOS的7.0-8.0,Windows系统2012。并行文件系统支持GPFS、Lustre和BGFS三种。
再上一层的是集群层,也就是CHESS的功能层。CHESS提供集群的部署、管理、监控、调度、报表、计费、项目管理、混合云管理、应用管理等。
再上一层是一个可选的容器层,如果你的应用是打包在容器里面的,CHESS也调动容器去运行。如果用户的应用是直接安装在操作系统上的,那就可以省略容器层。
再上一层是工具层,包含编译器、数学库和调试、调优等工具。
最顶层是应用层,理论上我们可以支持任何在操作系统上运行的应用软件。
联科这二十多年的工作,主要就是将各个行业的应用软件在底层的硬件平台上运行起来,运行得好。
CHESS Web Portal是CHESS的访问门户,用户可以使用自己的用户名和密码登录上来,登录后可以看到管理员分配好的功能和可访问的应用软件,每个应用都以图标的形式体现,参数可以根据用户的使用习惯去定制,方便用户快速、简单地使用集群提交作业。
CHESS安全控制模块主要是应用于军工行业需要保密认证的场景,提供三员管理、项目管理和密级管理等功能。三员包括系统管理员、安全员和审计员。
CHESS调度系统是集群中最核心的一个软件功能,调度的配置合不合理,策略是不是优化,直接影响集群的使用效率。CHESS支持LSF、Slurm和PBS等多种调度器,相应的,CHESS也具备各种调度算法,比如说预约、抢占、公平共享等。CHESS也支持GPU的调度,包含GPU的单机单卡、单机多卡和多机多卡的调度,也支持人工智能框架的调度。
CHESS提供用户管理的功能,可以在CHESS集群中自建用户,也可以与企业已有的LDAP或AD账户对接,也可以导入企业组织架构进行管理。
同时CHESS支持二级管理员的功能,因为系统管理员很多时候不太了解部门内部或者是项目内部的使用情况,所以可以把更细粒度的用户管理以及作业管理下放给二级管理员。CHESS也支持权限和角色的管理和定制。
CHESS提供应用管理的功能,管理员可以根据用户的使用习惯,利用系统已经提供的组件,拖拽式地形成各种应用模板的交互参数,也可以给每个应用模板分配访问权限,并且在应用模板里面,一旦应用运行起来,用户可以看到这个应用的输入、输出,比如查看应用运行到哪一步了,有没有错误输出。
在应用的运行目录下,用户可以看到是不是有相应的数据生成,以及运行过程中可以看到CPU和内存的使用情况。另外有一些应用有交互的参数,用户可以在运行过程中实时查看。
CHESS的三维远程可视化主要是用于CAD的前处理和后处理场景,我们采用VNC或者DCV 的技术实现二维或者是三维的远程可视化。CHESS提供这个功能以后,用户可以把前处理和后处理整个都放在集群上,即用户不需要前处理或者后处理在自己的工作站上进行,所有的数据可以直接在集群上生成计算并且查看结果。
CHESS提供数据管理的功能,就是用户不需要再去学Linux各种命令。在数据管理里面,用户可以利用鼠标去进行文件的上传、下载、压缩、解压、复制等等功能。
CHESS提供资源管理功能,可以对集群中的CPU、GPU以及混合云上的节点进行管理。在节点管理里,用户可以看到节点CPU、内存使用情况和作业分布情况,以及可以看到节点负载情况。用户可以通过这个功能来诊断是不是有些作业占用的CPU和内存异常,以及是不是有一些未通过调度系统提交上来的作业,比如一些挖矿的程序。
CEHSS还支持资源限制,用户可以对部门或者是项目组进行资源管理,比如说可以设置每个部门能使用的CPU核数以及同时运行的作业数。
CHESS提供监控模块,主要是对单机或者整机的CPU、内存、网络、硬盘的使用情况进行实时监控,同时提供机柜图的展示,用户可以看到每一个机器的物理位置以及状态。通过这个机柜图,用户可以直接对机器进行远程开关机操作,也可以登录它的命令行终端或者是图形终端来访问操作。
CHESS计费系统支持费用的充值、打折和透支,就是可以给用户或者部门设置能使用的所有资源数,比如说总的核数或者总的金额数,也可以对不同用户或部门提供给不同的打折系数。也提供用户详单,保证收费公开透明,用户可以查到每一条消费记录,就跟我们手机查账单一样,可以看到每一条作业的开始时间、结束时间、运行的总核时数以及CPU或内存的定价情况。可以设置CPU、GPU、内存和存储的费率,同时也可以支持计费的报表,可以统计某个时间段范围内某个用户或者是某些部门的总体费用情况。
CHESS也提供集群报表的功能,主要有两类的信息,一类是作业的信息,可以从用户、部门、队列和项目等维度,在某一个时间段范围内查看作业的总数、总核时数以及平均排队时间等。一类是机器资源的报表,包含CPU、GPU、内存和存储的使用率报表。
CHESS的许可证管理功能主要是针对应用软件的许可,进行管理、监控、调度、报表和计费。对即将过期的许可证,提供预警功能,对许可证的Vender或者Feature设置费率,可以随时看到许可证的使用情况以及服务状态。
CHESS也提供流程管理功能,可以拖拽应用模板,生成一个有依赖关系的任务流程,可以在这个应用模板里面自定义依赖关系,同时在运行过程中,可以随时查看整个流程的执行状态,可以显示每一个子任务的运行状态。
CHESS支持消息管理功能,管理员可以发布首页公告,也可以给某一个用户或者是某一类用户发布消息。普通用户可以看到管理员的公告,也可以看到作业的信息,比如作业什么时候开始运行,作业出错了或者是作业运行结束了,也可以看到计费的信息。
CHESS支持Caffe、Tensorflow等人工智能框架的调度,同时也支持GPU、单机单卡、单机多卡和多机多卡的调度。可以实现基于Docker的单机训练和推理,以及基于Singularity的多机训练和推理,同时也可以把Tenserflow的这样的工具集成进来,直接打开运行过程中的这个结果进行查看。
CHESS支持对接阿里云、腾讯云、华为云等公有云的混合云调度,可以在本地资源不足的情况下,把一些任务调度到公有云上,在公有云上可以支持包周期和按需调度两种。
CHESS的优势有以下几个方面:
第一个是刚刚提到的,支持混合云功能,我们可以在本地资源不足的时候,将计算资源直接调用到公有云上或者是超算中心上。
第二个,CHESS支持私有集群的管理,包括快速部署、集中管理、智能化的调度。
第三个,CHESS支持GPU的监控与调度,支持GPU的单机单卡、单机多卡和多机多卡的调度。
第四个,CHESS支持多种架构,比如X86和ARM的架构,支持Linux、AIX和Windows混合集群。
五、支持多种AI框架,比如Tensorflow和Caffe。
六、支持多种容器,比如Docker和Singularity。
成功案例
第一个案例是鞍钢北京研究院,该研究院主要研究钢铁结构和材料。使用CHESS搭建了一套集群系统,可以运行Fluent、Ansys、VASP等应用软件。
通过这样一套集群系统,可以大大简化用户的管理和使用,让用户很方便地把集群用起来,提高了应用的效率。
第二个案例是上海泛智能源。
用户原来使用工作站进行计算,但由于算力不足,后来采用HPC集群进行仿真设计,用户一共采购了三期戴尔的硬件设备,都是使用CHESS来进行管理,主要使用Abaqus、Numeca、Ansys、Fluent和CFX等软件。
用户在原来的工作站上运行一个作业要四十八个小时,也就是说今天下午运行,后天下午才能看结果。在使用CHESS平台之后,做到了今天上班提交任务,下班就可以查看结果,计算效率提升了四倍。
第三个是中科合成油的案例,用户主要研究如何用煤来制油,应用主要有量化和流体两类。
我们参与的其实是第四期项目,主要工作包括前期的方案设计、建设过程中的系统搭建和应用的优化,最终应用的性能也远超之前的集群。
后来用户就把前三期集群都统一由CHESS来管理,帮助用户完成了利旧的机器以及新购机器的整合,整套集群的使用率超过了百分之八十。
在这套集群上,用户发表两百多篇文章,申请八项专利以及两项软著。
第四个是宝钢研究院的案例,用户使用人工智能的技术对钢铁生产过程中进行质量监控。
采用CHESS进行集群的管理和GPU的调度,使用Lustre搭建并行文件系统,提高了IO带宽。同时我们也集成了Habor的容器仓库,很方便用户使用。
通过CHESS来调度Caffe和Tenserflow等人工智能的框架,最终简化了管理和使用,使整套集群快速投入到生产当中去。
第五个是一个军工研究所的案例。
本项目的特点是首次在国内搭建了一套私有云加HPC的平台,私有云使用的是阿里云。
过去云平台和HPC都是分开建设的,因为他们的用法本来就是相反的,私有云是将一个核给多个人用,运行一些服务。而HPC因为计算量大,单机单核不能满足计算需求,所以要使用很多核进行计算。
第六个是另一个军工行业的案例,该项目分两期建设,一共五百多台服务器。
这个集群除了供所内使用以外,还通过了保密认证,挂到了金航网上,对航空系统提供计算服务,我们也提供了相应的计费功能。
第七个是一个EDA公司的案例,软件产品采用CHESS进行用户的管理、资源的管理和集群的监控,使用LSF进行调度,同时在CHESS的基础上开发了应用许可证的管理功能,将多种产品组合,满足了用户比较复杂的应用场景。通过定制化开发的许可证的管理、监控、报表和成本核算功能,对应用进行了精细化的管理。
生态合作伙伴
硬件方面,我们与Intel、戴尔、希捷等硬件厂商都有战略合作,尤其是戴尔,从2003年开始合作,迄今为止已经联合交付了一百多个集群项目。
现在双方也联合推出了制造行业解决方案,发挥戴尔的企业级硬件和联科软件与服务的优势,强强联合打造出最优的企业级解决方案。
操作系统方面,我们是加入了龙蜥社区,同时跟麒麟软件完成了兼容性测试。
国产化并行文件系统我们与焱融科技完成了产品的兼容性测试。
在云计算方面,跟阿里云、腾讯云、华为云和青云都有联合打造混合云和公有云的解决方案。
未来我们也希望与更多生态合作伙伴联合,汇聚生态之力,共创超算价值。
感谢各位嘉宾的聆听,谢谢大家。


